佛道概念的决策论形式化:可计算的桥与边界
沈马成(研究发起)与 AI 研究助手协作
1. 白话结论
把“开悟”理解成知道得越来越多,直觉上很诱人,但知识更完整并不自动让人放下执著。更稳妥的 H-Bridge 说:只有当一个模型也能看见自己的局限,并允许“有些事不可控”的知识修订原有偏好时,认识增加才可能减少内在冲突。无为最能被形式化的部分,是借助环境自身的动力,只在关键处付出必要控制,而不是什么都不做。知行合一可拆成三个可研究层次:感知与行动共享目标、熟练行动由规划蒸馏而来、某些因果知识必须经干预才能获得。玩具实验支持 H-Bridge 的条件交互和适中自我精度的权衡,但其中的成功只属于预先写下的模型。无为实验反而没有达到预注册成功阈值,因此不能把漂亮的节能结果说成验证。数学能够澄清结构、提出反例,却无法给“纯粹觉知”、良知的道德来源、彻底无意图或存在性之苦下定义。这里的形式化应当被当成可检验的地图,而不是宗教体验或传统本身。
2. 逐概念对照表
| 传统概念 | 形式对象 | 强度 | 主要失真 |
|---|---|---|---|
| 无为 | LMDP:在被动动力学上按可欲性重加权,控制偏离用 KL 计价 | 强控制问题 | 仍预设目标函数,无法表达“连目标也放下” |
| 知行合一 | 控制即推断;规划蒸馏;观察与干预的因果差异 | 强至部分 | 抓到结构,却丢失良知、心即理和道德动机 |
| 开悟 | 任务相对的世界模型误差、偏好精度及其可更新性 | 部分 | “完整模型即开悟”过强;知识也可能加剧冲突 |
| 无我 | 自我隐变量及其精度 \(\gamma_{self}\) | 部分 | 降低僵硬先验不等于证得无我,也不等于删除行动者 |
| 执著、渴爱与苦 | 不可控情境中的高偏好精度与持续风险项 | 部分 | 只能近似“求不得”的冲突,不能穷尽生老病死与行苦 |
| 空 | 模型族、粗粒化与统计不可识别性 | 修辞至部分 | 工程上的“表征无自性”不能替代中观论证;该形式化本身也非终极描述 |
| 缘起 | 结构因果模型与干预分布 | 部分 | 固定变量和因果边,无法承载缘起的全部伦理与本体含义 |
| 止观、元觉知 | 对注意精度分配的二阶推断 | 部分 | 是计算提议,不是已确证的冥想神经机制 |
| 顿悟与渐悟 | 连续证据累积与 MAP 模型的离散翻转 | 部分 | 不包含解脱、伦理转变与传承认证 |
| 中道 | 明确目标下的帕累托前沿 | 修辞至部分 | 不是参数取中间值,也不是一般折中主义 |
| 道法自然、上善若水、反者道之动 | 生成过程、柔顺控制、负反馈 | 修辞 | 若不产生独立预测,就只是现代术语重命名 |
3. 开悟张力:A / B / Bridge 与 T3
H-A:认识完备
探索越充分、模型越准确,冲突就越低。问题是事实知识并不决定偏好:更准确地知道坏结果不可避免,也可能令固定执取更痛苦。
H-B:执取释放
减少执取本身足以降低冲突,不依赖认识增长。问题是若看不见自己的控制冲动及其后果,偏好很难被有针对性地修订。
H-Bridge:条件桥
认识增长只有在两个桥因子同时存在时才导向释放:模型能表征自身建模与控制局限;偏好能被“不可控”的证据更新。
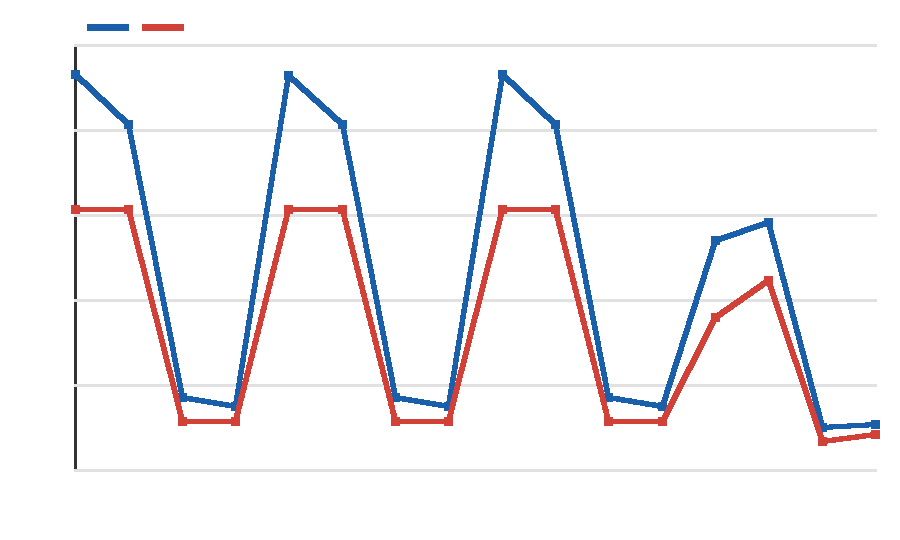
T3 在 16 个条件、每格 800 次的生成性玩具实验中给出清楚的交互:完整桥下,高探索使 distress 改变量为 −1.509;无桥时为 +4.369;双重差分为 −5.878。预设的“桥内外探索效应差小于 1”杀死条件没有触发。它反对 H-A 的无条件充分性,并支持 H-Bridge 在这个模型中的可区分结构;由于机制本来就按 H-Bridge 写入,结果不是对现实心理机制的独立验证。
4. 无为:LMDP 与 T1 负面结果
线性可解马尔可夫决策过程把每一步代价写成状态代价与偏离被动动力学的 KL 代价:
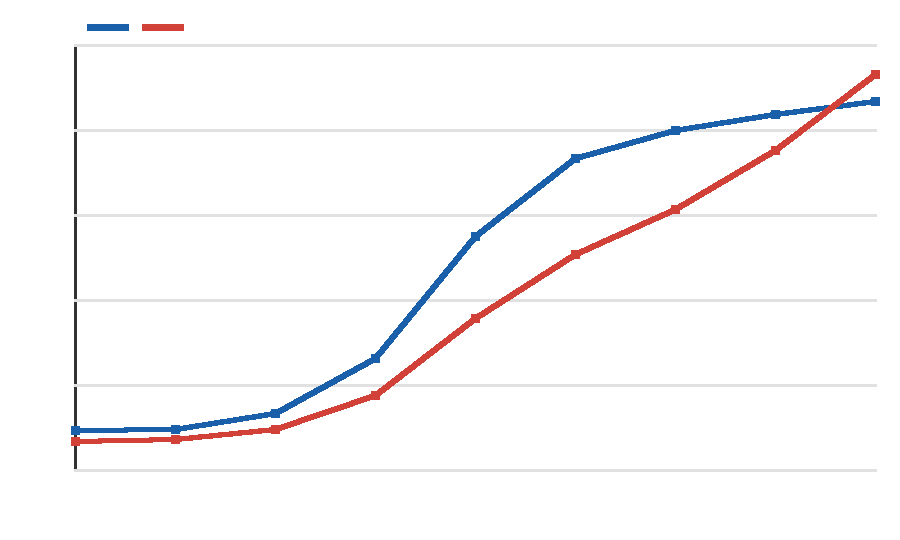
这给出一个精确的工程弱版:好控制不是动作归零,而是在自然流上重加权,把控制集中到真正改变可达结果的关键处。它能区分顺势控制、随机漂移和持续蛮力。
5. 知行合一三层
- 统一目标:主动推断把状态估计和行动选择写进同一个优化目标。“知”与“行”在计算上相互约束,而不是先后完全独立的模块。
- 摊销蒸馏:慢速规划器产生策略,再把它蒸馏进快速参数策略。反复实践把显式推演编译成流畅技能,解释“知道如何做”与“做得出来”的差别。
- 干预知识:在存在混杂时,观察 \(P(Y\mid X)\) 一般不能识别干预 \(P(Y\mid do(X))\)。因此某些因果知识必须通过行动获得;这是“知而不行”的严格弱版本。
这三层没有形式化王阳明所说的良知。它们描述统一控制、技能形成与因果识别,而不是证明道德知识先天存在,也不能从性能指标推出“心即理”。
6. T2:自我精度的承诺—恢复权衡
T2 在规则改变的 POMDP 中扫描 \(\gamma_{self}\in\{0,0.35,1,3\}\)。适中精度 \(\gamma_{self}=1.0\) 的总回报最高,为 40.029:精度接近零时恢复快,却较难形成长期承诺;精度很高时承诺强,却在规则反转后恢复慢、累计风险更高。预注册的杀死条件——端点回报最高,或精度既不影响恢复也不影响承诺——没有触发。
futile_control_rate 在所有条件下都等于 1,因为不可控阶段每一步仍被迫选一个动作;这个指标已退化、没有辨别力,结论只依赖累计风险、恢复、承诺与总回报。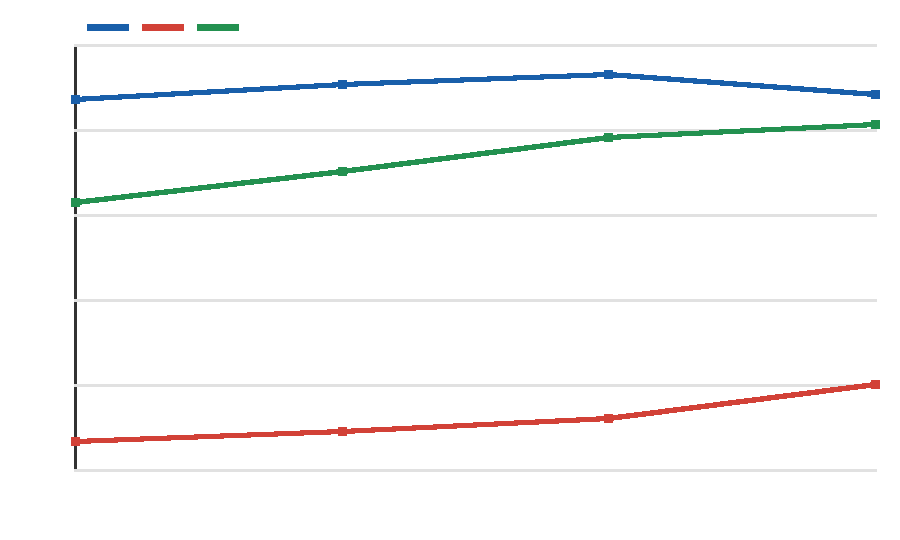
7. 形式化失效处
- 觉知本身:方程可以描述被注意的内容和注意资源如何分配,却没有解释为什么存在体验。
- 良知的道德本体:先验可以编码偏好,却不能仅凭推断框架说明道德法则为何有效、从何而来。
- 无为的无意图性:所有控制模型都预设目标;“高效追求目标”不是“从目标本身脱落”。
- 苦的完整谱系:风险项能模拟欲求与不可控之间的冲突,不能把行苦、生老病死或存在性不满足压成一个预测误差。
- 空对描述语言的反身限制:统计不可识别性只是类比;把信息或模型抬成终极实体,同样会成为被批判的对象。
- 传统内部差异:不同佛教传统对觉悟与全知的关系并无单一答案;顿渐之争、老庄与后世道教也不能被一条学习曲线统一。
8. 两份分析的分歧,以及一般性治理问题
关于“空”
一份分析把模型依赖、粗粒化与不可识别性视为部分可操作对应;另一份更强调:这仍只是认识论类比,中观会进一步质疑“信息”本身是否有终极地位。合并后的立场是:工程对应可用,但强度不得高于“部分”,更不能借它建立新的实体论。
关于“无为”的盲区
形式稿突出 LMDP 的强数学结构和可杀实验;批判稿强调其目标函数从未消失。合并后的立场是:对“少偏离自然动力学的控制”,对应很强;对经典语境中的无意图、自发性与政治伦理,只能部分甚至修辞对应。
紧耦合不等于权力集中
个体或单一系统中的感知—行动紧耦合,是信息快速回流的设计;组织治理中把感知、判断、执行和审查集中给同一节点,则会削弱纠错与问责。二者可兼容,但层级边界必须明确:执行回路可以紧,授权与验证仍应分离;局部的统一目标不能自动成为制度集权的理由。
9. 可证伪预测
- 无为控制:若目标与自然吸引子对齐,应存在高成功率、低 KL 的控制点,且控制成本集中在势垒附近。T1 已因成功率 0.927 未达到 0.95 而失败。
- 自我精度:适中 \(\gamma_{self}\) 应同时优于两个端点,并展示承诺—恢复权衡;若端点最佳或两个读出均不变,则该操作化失败。T2 暂未触发此条件。
- H-Bridge:探索降低冲突的效果应依赖“偏好可更新”和“模型含自身局限”同时成立;若桥内外效应差小于 1,设计不可区分。T3 暂未触发此条件。
- 干预知识:含混杂的任务中,主动干预者的因果误差应低于等量纯观察者;若无差异,知行合一的因果弱版失败。
- 蒸馏:规划后蒸馏应在保留迁移性能时降低行动延迟;若没有速度收益或迁移明显恶化,技能层映射失败。
- 顿渐机制:连续证据可伴随 MAP 结构选择的离散翻转;若纯参数学习者出现同样跳变,或结构模型没有阈值行为,该解释失去区分力。
- 元觉知:可更新的二阶精度应在规则改变后比固定注意增益更快恢复校准,且不损害稳定期辨别力;否则该建模提议被削弱。
10. 不宣称清单
- 不宣称佛学、道家思想或开悟已被模拟证明。
- 不宣称自由能原理解决了意识难题,也不把变分自由能无条件等同热力学自由能。
- 不把苦等同奖励预测误差、负奖励或单个 KL 项。
- 不把无我等同删除自我状态、人格解体、失能或免除责任。
- 不把空等同虚无主义、统计不确定性或“万物皆信息”。
- 不把无为等同不行动、随机策略、最低能耗或某个温度极限。
- 不把中道等同参数取 0.5,也不把顿悟等同神经网络相变。
- 不把知行合一等同“先做再说”,更不把系统内紧耦合当作集中授权的正当性。
- 不把良知等同奖励函数,不把道等同生成过程或 Solomonoff 先验。
- 不把玩具实验、工程成功或吸引子图升级为本体论证据。
- 不宣称传统内部只有一种立场,也不宣称这里的桥接具有未经比较的新颖性。
11. 参考文献
只列两份研究稿中原本带有链接的条目。“已核验”沿用稿件的核验标记;本次合并未重新逐条访问外部页面。其余一律标为“未核验”。
- Friston, K. (2010). “The free-energy principle: a unified brain theory?” Nature Reviews Neuroscience, 11, 127–138. DOI(已核验)
- Todorov, E. (2007). “Linearly-solvable Markov decision problems.” NeurIPS 19. Proceedings(已核验)
- Kappen, H. J. (2005). “Path integrals and symmetry breaking for optimal control theory.” JSTAT, P11011. arXiv(已核验)
- Ortega, P. A., & Braun, D. A. (2013). “Thermodynamics as a theory of decision-making with information-processing costs.” Proceedings A. arXiv(已核验)
- Leike, J., & Hutter, M. (2015). “Bad Universal Priors and Notions of Optimality.” COLT / PMLR 40. Proceedings(已核验)
- Laukkonen, R. E., & Slagter, H. A. (2021). “From many to (n)one.” Neuroscience & Biobehavioral Reviews, 128, 199–217. PubMed(已核验)
- Van Dam, N. T., et al. (2018). “Mind the Hype.” Perspectives on Psychological Science, 13(1), 36–61. PubMed(已核验)
- Seth, A. K. (2013). “Interoceptive inference, emotion, and the embodied self.” Trends in Cognitive Sciences, 17, 565–573. PubMed(已核验)
- Deane, G. (2020). “Losing Ourselves: Active Inference, Depersonalization, and Meditation.” Frontiers in Psychology. PMC(已核验)
- Sandved-Smith, L., et al. 相关元觉知与深参数主动推断工作。arXiv(未核验)
- Wang Yangming. Instructions for Practical Living and Other Neo-Confucian Writings, trans. Wing-tsit Chan (1963). Open Library(已核验书目)
- Dao De Jing. Chinese Text Project(已核验入口;章节版本仍须单独核对)
- 早期佛典检索入口:SN 12、SN 22.59、SN 56.11、DN 22(已核验入口;传统解释不唯一)